Redis 大 Key 实验:排查、主线程延迟、网络背压、删除与拆分
这次实验围绕四个问题展开:怎样找到大 Key?操作大 Key 会不会阻塞主线程?慢客户端如何造成网络背压?怎样删除、拆分和预防大 Key?
实测结果:一个包含 10 万字段的 Hash 占用约 20.57 MiB;同步 DEL 耗时 20.357 ms,UNLINK 的前台执行耗时只有 0.041 ms;拆成 16 片后,分片 00 有 6220 个字段,占用约 1.25 MiB。
图像说明:原实验终端使用透明背景。本文配图依据原始截图中的命令与数值重新排版为不透明终端图,部分长记录只摘取相关字段;不是重新运行所得的截图。容器名在教程中统一写作
redis-test。实测使用 Redis 7.2.16;耗时随机器负载变化,不是性能保证。
1. 用 Docker 创建实验环境
1.1 拉取镜像,再创建容器
Docker 拉取的是镜像,docker run 才会创建并启动容器。假设已经安装并启动 Docker,在 Linux 终端执行:
docker pull redis:7.2.16

docker run -d \
  --name redis-test \
  -p 127.0.0.1:6380:6379 \
  redis:7.2.16

docker ps --filter name=redis-test
这里使用本机 6380,避免与已有的 6379 Redis 冲突。容器内部仍是 6379;端口只绑定本机。这是一次性实验环境,没有额外挂载持久化目录。
1.2 进入数据库 3
仍在 Linux 终端执行:
docker exec -it redis-test redis-cli -n 3看到下面的提示符,表示已进入 Redis 的数据库 3:
127.0.0.1:6379[3]>验证连接:
PING返回 PONG。若已进入 Redis 但未选择数据库,可以执行 SELECT 3;输入 exit 返回 Linux 终端。
| 执行位置 | 命令示例 |
|---|---|
| Linux 终端 | docker exec ...、python3 ...、redis-cli --bigkeys |
| Redis 内部 | GET、HLEN、MEMORY USAGE、LATENCY LATEST、SLOWLOG GET |
--bigkeys 是 redis-cli 的启动选项,不能直接输入到 Redis 内部。MEMORY USAGE key 中的 key 是占位符,需要替换成实际键名,不要再额外保留单词 key。
数据库编号不隔离 CPU、主线程或实例配置。数据库 3 里的慢命令仍可能影响同一实例的其他数据库。本教程用单独容器便于隔离实验。
2. 准备实验数据
下载配套 lab.py 实验脚本(在新窗口打开),保存到当前目录。脚本只依赖 Python 3 标准库,默认连接本机 6380、数据库 3。
在脚本所在目录的 Linux 终端执行:
python3 lab.py seed脚本创建以下数据,键名前缀均为 lab:bigkey:20260929:,TTL 为 24 小时。Hash 每次写入 500 个字段,避免用一个巨大的 Lua 脚本长时间占用主线程。
| 完整键名 | 类型 | 数据量 | 实验用途 |
|---|---|---|---|
lab:bigkey:20260929:small | String | hello,5 字节 | 小 Key 对照 |
lab:bigkey:20260929:string32m | String | 32 MiB | 扫描计算与网络背压 |
lab:bigkey:20260929:hash100k | Hash | 10 万字段,每个值 128 字节 | 删除与拆分 |
lab:bigkey:20260929:hash100k-delete | Hash | 同上 | DEL 对照 |
已存在实验 Key 时,造数脚本会拒绝覆盖。清理和重新造数的方法见文末。若主动使用其他主机端口,可以通过 REDIS_PORT=端口号 python3 lab.py ... 指定;容器内部的 docker exec ... redis-cli 不受主机映射端口影响。
3. 排查:bigkeys 到底能告诉我们什么?
3.1 找出每种类型最大的 Key
在 Linux 终端执行:
docker exec -it redis-test redis-cli -n 3 --bigkeys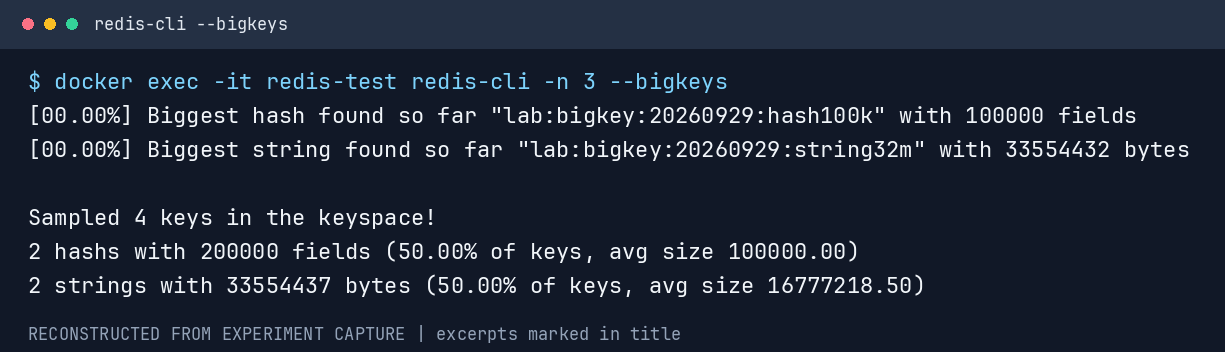
--bigkeys 遍历当前数据库,查找每种类型中最大的 Key,并统计各类型的数量及平均大小。它没有按某个阈值筛选“所有大 Key”,也不是统一的内存排行榜。
| 类型 | bigkeys 比较的指标 |
|---|---|
| String | 值的字节数 |
| Hash | 字段数量 |
| List、Set、ZSet | 元素数量 |
| Stream | 条目数量 |
例如,两个 Hash 分别有 10 万和 8 万字段,如果业务把超过 1 万字段定义为大 Key,那么两者都符合。但 --bigkeys 的最终汇总只报告字段最多的 Hash。并列最大时不保证列出所有并列项。
扫描中的 Biggest ... found so far 表示“截至当前发现的最大 Key”。前面的 [00.00%] 是发现时显示的扫描进度,不是大小占比;本次只有 4 个 Key,在首批扫描处理时就发现了最大项。判断最终结果应看 summary。
3.2 读懂汇总行
2 hashs with 200000 fields (50.00% of keys, avg size 100000.00)2 hashs:数据库共有 2 个 Hash Key,不是识别出了 2 个超阈值大 Key。200000 fields:两个 Hash 的字段总数为 20 万。50.00% of keys:Hash 占全部 4 个 Key 的一半,不是内存占比。avg size 100000.00:平均每个 Hash 10 万字段,不是 10 万字节。
Total key length in bytes is 117 指键名总长度,不是存储数据的总大小。
3.3 测量内存和字段数
在 Redis 内部执行:
MEMORY USAGE lab:bigkey:20260929:hash100k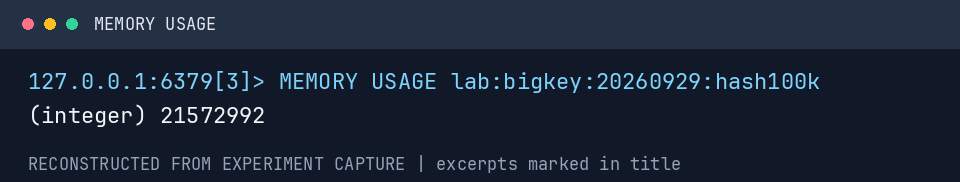
21572992 的单位是字节,换算为 21572992 / 1024 / 1024 ≈ 20.57 MiB。内存统计包含键名、数据和相关管理开销,不等于值的原始字节数。
HLEN lab:bigkey:20260929:hash100k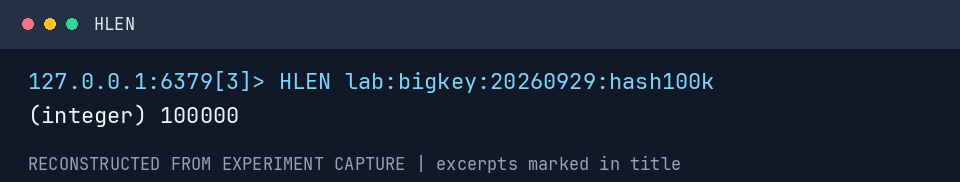
集合的 MEMORY USAGE 默认使用抽样估算;实验中可加 SAMPLES 0 遍历全部元素,但大集合会增加执行开销。
如果要按内存寻找大 Key,在 Linux 终端使用:
docker exec -it redis-test redis-cli -n 3 --memkeys如果要统计“内存超过 10 MiB 的所有 Key”,需要自行用 SCAN 分批遍历,再用 MEMORY USAGE 比较阈值并计数。生产扫描应控制速率,并处理 SCAN 可能重复返回 Key 的情况。
参考:MEMORY USAGE。
4. 实验一:观察主线程执行延迟
4.1 开启内部延迟监控
先在 Redis 内部记录原配置,便于实验后恢复:
CONFIG GET latency-monitor-threshold
CONFIG GET slowlog-log-slower-than
CONFIG GET lazyfree-lazy-user-del
原实验的慢日志阈值为 10000 微秒,lazyfree-lazy-user-del 为 no。开启 1 毫秒阈值的延迟事件监控:
CONFIG SET latency-monitor-threshold 1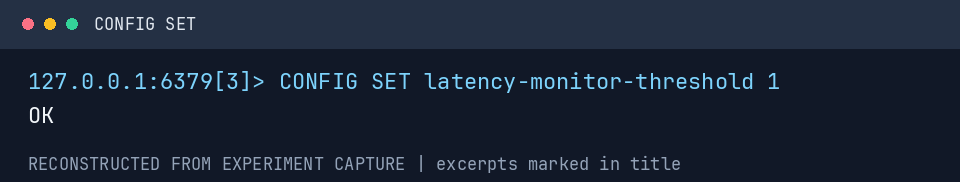
4.2 对大字符串执行计算
BITCOUNT lab:bigkey:20260929:string32m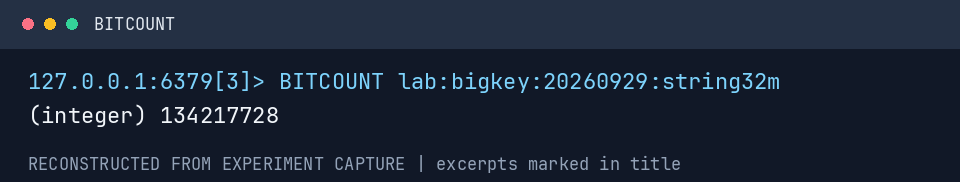
BITCOUNT 遍历字符串并统计二进制位中 1 的个数。返回的 134217728 是位计数结果,不是执行时间。
LATENCY LATEST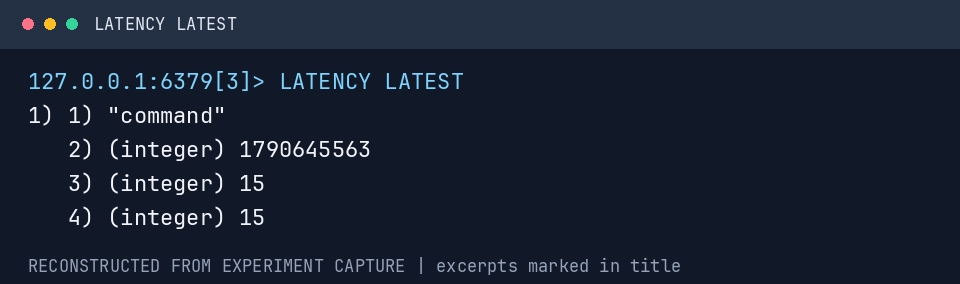
四项分别为事件名称、最近事件时间戳、最近延迟和历史最大延迟。后两项单位都是毫秒。本次记录了一个 command 事件,最近和最大延迟均为 15 ms。
这里记录的是命令类延迟事件,不带具体命令名。在存在其他流量时,不能仅凭该记录断言一定由 BITCOUNT 产生;需要慢日志确认具体命令的耗时。
继续查看历史与图形:
LATENCY HISTORY command
LATENCY GRAPH command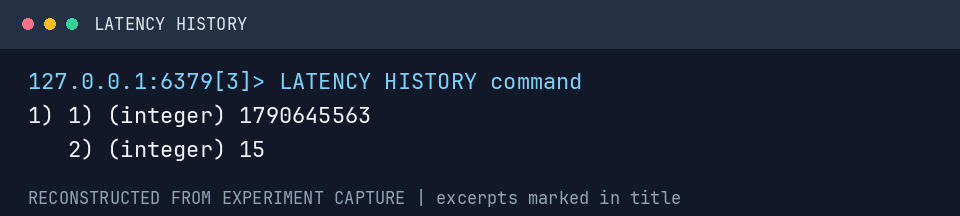
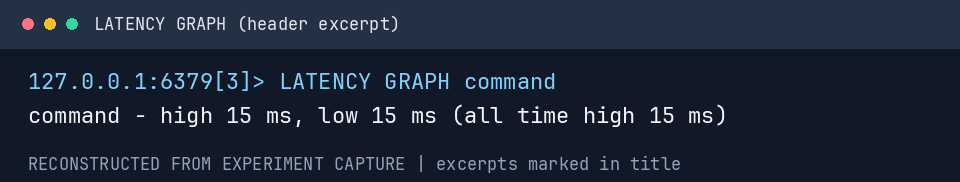
返回空数组意味着没有记录到满足阈值的事件,不意味着命令没执行。
4.3 用慢日志测量具体命令
为了记录很快的小 Key 操作,临时将阈值设为 0:
CONFIG SET slowlog-log-slower-than 0
MULTI
GET lab:bigkey:20260929:small
SLOWLOG GET 1
EXEC
QUEUED 表示命令入队,EXEC 后依次执行。这里把 GET 和查询慢日志放在同一个事务里,避免其他客户端在中间执行 PING,导致最新记录被替换。
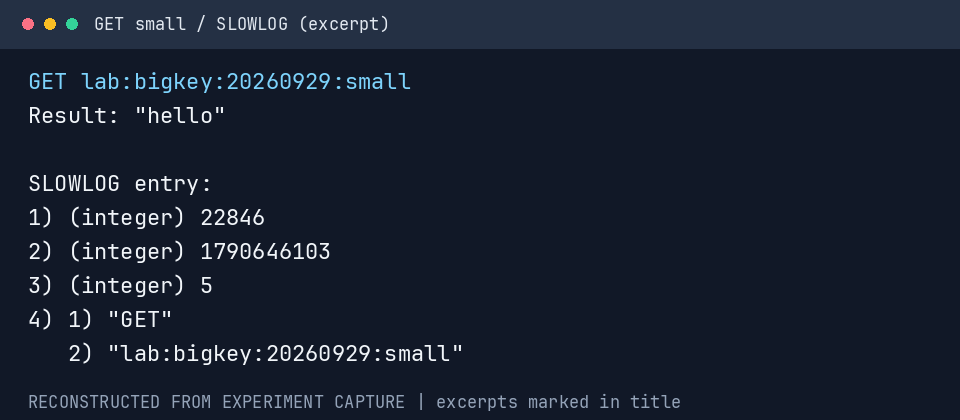
慢日志第 3 项是执行耗时,单位是微秒。本次小 Key 的 GET 用时 5 μs = 0.005 ms。
| 工具 | 时间单位 | 观察内容 |
|---|---|---|
LATENCY LATEST | ms | Redis 内部延迟事件 |
SLOWLOG GET | μs | 具体命令的服务端执行时间,不含网络传输等待 |
redis-cli --latency | ms | 客户端 PING 往返时间,包含等待与传输 |
为什么之前慢日志全是 PING?慢日志属于整个实例,另一个 --latency 客户端不断发送 PING,最新若干条记录可能被它占满。停止那个终端的监测,或采用上面的事务方法。
要精确测量 BITCOUNT,可将事务内的 GET 替换为:
MULTI
BITCOUNT lab:bigkey:20260929:string32m
SLOWLOG GET 1
EXEC
不能把 15 ms 与 5 μs 的差异直接描述成“大 Key GET 比小 Key GET 慢 3000 倍”:两次执行的命令不同,且使用的观测工具也不同。大 Key 的影响取决于操作;单字段 HGET 与全量 HGETALL 的开销差别很大。
若想观察其他客户端有没有被延迟,可提前在另一个 Linux 终端运行:
docker exec -it redis-test redis-cli -n 3 --latency观察 max,按 Ctrl+C 停止。采样可能漏掉短暂停顿,未见尖峰不等于没有延迟。
参考:Redis 慢日志、Redis 延迟诊断。
5. 实验二:慢客户端与网络背压
5.1 发出大响应请求,然后暂停读取
在 Linux 终端、脚本所在目录执行:
python3 lab.py slow-reader脚本设置客户端名称 bigkey-lab-slow-reader,请求 32 MiB 的字符串,然后 20 秒不读取响应,最后关闭连接。
在这 20 秒内,从另一个连接进入 Redis:
docker exec -it redis-test redis-cli -n 3在 Redis 内部执行:
CLIENT LIST TYPE normal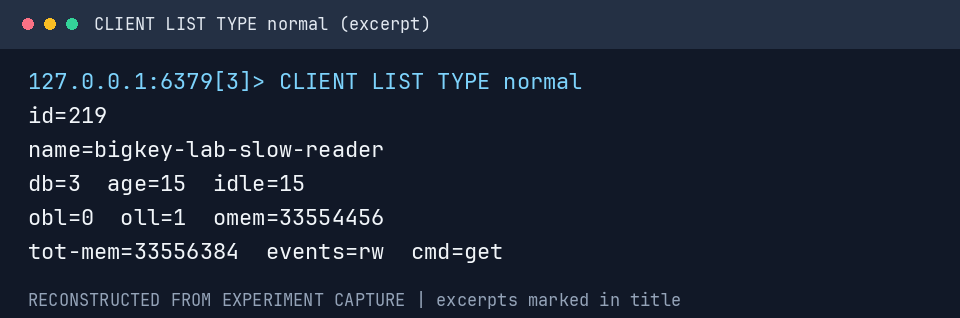
| 字段 | 实测值与解释 |
|---|---|
name | bigkey-lab-slow-reader,定位实验连接 |
cmd | get,最近执行的命令 |
omem | 33554456,约 32 MiB 的输出缓冲内存 |
oll | 1,输出缓冲链表有一个节点,不是一个字节 |
obl | 0,固定输出缓冲长度为零,不代表整个输出都已发完 |
events | rw,监听读写事件 |
客户端不读取,接收端和发送端的缓冲逐渐受到限制,Redis 无法把响应及时发送完,剩余数据保留在客户端输出缓冲中。omem 是分配的缓冲内存,不是精确的未发送字节数。
20 秒后脚本关闭连接,再次执行 CLIENT LIST TYPE normal,该客户端应消失,对应输出缓冲会释放。
5.2 背压不等于主线程一直等待网络
Redis 使用非阻塞网络 I/O。慢客户端暂停读取,并不意味着主线程同步等待 20 秒。实验期间另一个连接仍能执行 CLIENT LIST,说明服务器能够继续处理请求,但这不能排除短暂延迟。
这个实验验证的是慢客户端造成输出缓冲积压,没有证明物理网卡被打满。大量慢连接、大响应构造、带宽竞争和内存压力仍可能影响整体服务。
治理时应限制单次响应,按需读取;为正常客户端评估合适的输出缓冲限制,避免无上限积压。超过限制可能导致连接被断开,需要应用配合处理。
参考:Redis 客户端与输出缓冲。
6. 实验三:DEL 和 UNLINK 会不会阻塞主线程?
6.1 保证对照条件一致
两个 Hash 都有 10 万字段、值长 128 字节。在 Redis 内部检查:
HLEN lab:bigkey:20260929:hash100k
HLEN lab:bigkey:20260929:hash100k-delete
CONFIG GET lazyfree-lazy-user-del
CONFIG SET slowlog-log-slower-than 0
两次 HLEN 应返回 100000,配置应为 no。如果为 yes,DEL 也可能使用异步释放,不适合作为同步删除对照。仅在专用实验实例中,可记录原值后改成 no,结束时恢复。
6.2 同步 DEL
MULTI
DEL lab:bigkey:20260929:hash100k-delete
SLOWLOG GET 1
EXEC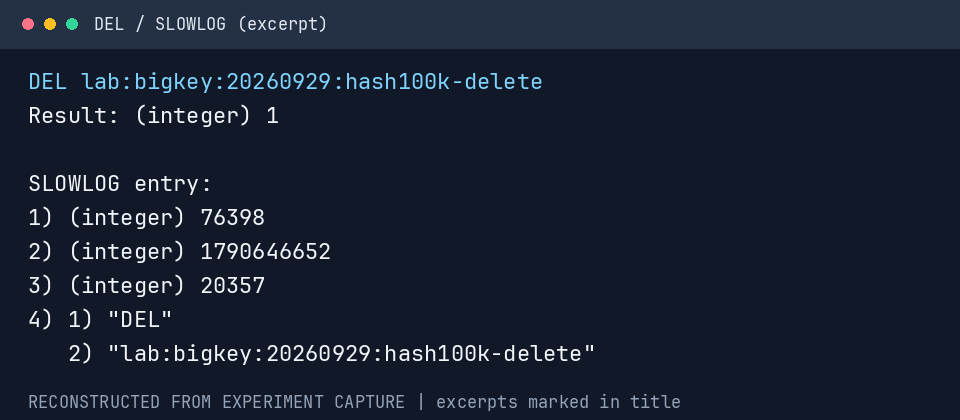
DEL 返回 1 表示成功删除;慢日志耗时为 20357 μs = 20.357 ms。主线程同步释放大 Hash 的大量分配,在命令执行期间无法执行其他客户端命令。
6.3 UNLINK
MULTI
UNLINK lab:bigkey:20260929:hash100k
SLOWLOG GET 1
EXEC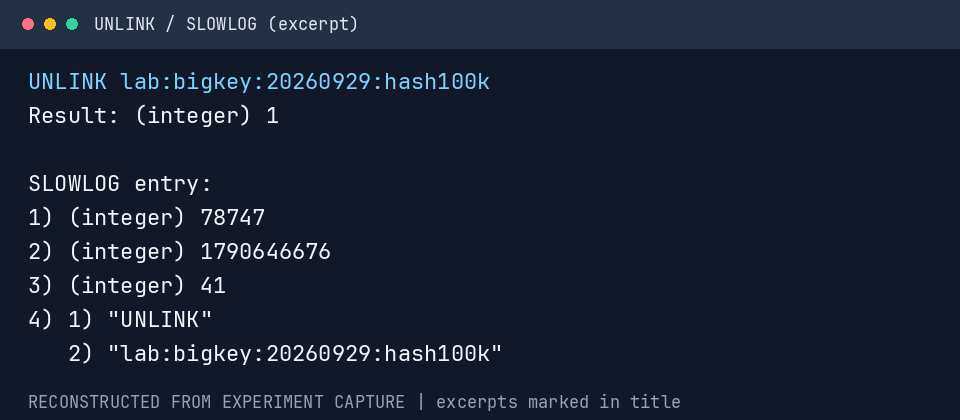
UNLINK 返回 1;耗时为 41 μs = 0.041 ms。对于本次大 Hash,它在主线程中移除 Key,并把昂贵的内存释放交给后台。
| 命令 | 实测前台耗时 | 本次内存回收方式 |
|---|---|---|
| DEL | 20.357 ms | 主线程同步释放 |
| UNLINK | 0.041 ms | 大 Hash 的释放交给后台 |
UNLINK 并非零耗时,也不代表 41 微秒内回收完了全部内存。它仍需执行字典移除等前台工作。对释放成本很低的对象,实现也可能直接同步释放;不应把所有类型一概理解为必然后台处理。
查看逻辑删除结果与后台状态:
EXISTS lab:bigkey:20260929:hash100k
INFO memory
EXISTS 应返回 0;lazyfree_pending_objects 表示待回收对象数,不是待回收字节数。你手动输入 INFO 前后台可能已经完成,因此看到 0 不能否认异步回收。内存归还分配器后,进程 RSS 也未必立即下降。
7. 实验四:拆分大 Hash
7.1 重建刚刚删除的 Hash
两个 Hash 都删除后,在 Linux 终端运行:
python3 lab.py seed-hashes该命令只重建两个 Hash,不覆盖小字符串和大字符串。任一 Hash 已存在时会拒绝继续,避免覆盖数据。
7.2 分批迁移到 16 个分片
python3 lab.py split脚本使用 HSCAN,每批 COUNT 500,在客户端按以下规则分组,再分批 HSET:
bucket = zlib.crc32(field_bytes) % 16新 Key 为 lab:bigkey:20260929:hash-shard:00 到 hash-shard:15。脚本继承源 Key 的绝对过期时间,核对目标字段总数与源 Hash 的字段数,并保留原 Hash以便比较。COUNT 是工作量提示,不是严格的返回数量上限。
在 Redis 内部查看其中一片:
HLEN lab:bigkey:20260929:hash-shard:00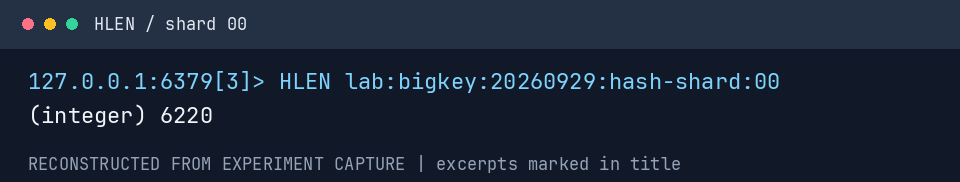
MEMORY USAGE lab:bigkey:20260929:hash-shard:00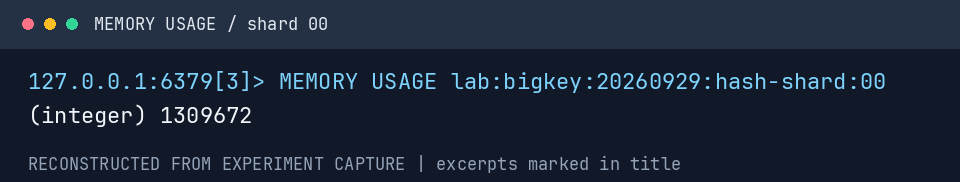
| 指标 | 原大 Hash | 分片 00 |
|---|---|---|
| 字段数 | 100000 | 6220 |
| 内存 | 21572992 B,约 20.57 MiB | 1309672 B,约 1.25 MiB |
平均每片应为 6250 字段,但哈希分布不完全均匀,因此分片 00 实际是 6220。未来读写都必须用相同的 CRC32 规则定位分片,不能直接用不同语言默认的 hash 函数替代。
7.3 拆分解决什么问题?
拆分降低了访问、遍历和删除单个分片的最大工作量,也更容易让请求之间获得调度机会。但拆成 16 片后一次性读回全部数据,总数据量并未减少;更多请求与 Key 管理开销可能增加总耗时和总内存。
本次保留源 Hash,相当于同时保存两份数据,所以总内存暂时增加。拆分不是压缩,也不自动消除热点;同一个实例仍共享主线程。
此脚本适用于静态实验:字段总数相同不等于在线迁移的数据完全一致。生产迁移还需要协调并发写入、增量同步、内容校验、读写切换和回滚。确认切换成功后,才删除源 Key。
8. 预防:让大 Key 不再无限增长
- 明确业务阈值。同时关注单值字节数、集合元素数量和实际内存。阈值应依据延迟预算、响应大小和读写模式设定,不存在所有业务通用的唯一标准。
- 写入前限制大小。限制序列化后的消息大小;集合按用户、时间或哈希桶分组,避免所有数据集中于一个 Key。
- 按需读取。能用 HGET/HMGET 就不全量 HGETALL;必须遍历时用游标分批处理,并控制单批响应大小和请求速率。
- 合理过期。TTL 防止长期遗留,但不能阻止有效期内无限增长;过期时间适当打散,避免集中回收。
- 控制客户端积压。限制大响应和并发,监测输出缓冲,为慢客户端设计限流和断连后的恢复策略。
- 持续监测。低频、限速扫描大 Key,结合慢日志、内部延迟事件、客户端往返延迟、内存和网络指标判断原因。
- 删除大集合优先考虑 UNLINK。同时监测后台回收积压,避免短时间内大量逻辑删除导致内存仍来不及回收。
大文件通常更适合对象存储,Redis 保存索引或访问地址。对于大 JSON,也可以按业务访问边界拆分,而不是每次读取整个对象。
9. 恢复配置、清理与复现
在 Redis 内部恢复之前记录的配置。以下是原实验慢日志阈值,以及关闭延迟监控的示例;若实验前配置不同,应恢复实际原值:
CONFIG SET slowlog-log-slower-than 10000
CONFIG SET latency-monitor-threshold 0
若改动了 lazyfree-lazy-user-del,也恢复原值。另一个终端的 --latency 用 Ctrl+C 结束。
在 Linux 终端清理本实验前缀下的 Key:
python3 lab.py cleanup脚本用 SCAN 加 UNLINK,只处理数据库 3 的实验前缀,不执行 FLUSHDB/FLUSHALL。重新开始完整实验:
python3 lab.py seed需要再次运行拆分时,目标分片必须不存在;完整重复实验可以先 cleanup 再 seed。临时暂停容器可用 docker stop redis-test,下次用 docker start redis-test。
本文脚本与图片随笔记一起保存,不依赖最初实验时的 /tmp 路径。